Foram encontradas 5.370 questões.
Um cientista de dados está utilizando máquinas de vetor de suporte (SVM) em um projeto de classificação, pois deseja evitar o overfitting do modelo aos dados de treinamento.
Qual das seguintes técnicas auxilia a prevenir o overfitting em SVM?
Provas

Em um projeto de classificação de textos, um modelo de machine learning foi aplicado em um conjunto de teste e apresentou os seguintes resultados: uma precisão de 80% e uma revocação de 70%.
Com base nessas informações e considerando-se apenas a parte inteira da porcentagem, qual é o F1 Score desse modelo?
Provas
Um pesquisador possui um conjunto de dados consistindo em características diversas, features, e suas respectivas classificações, labels. Ele deseja dividir esse conjunto de dados em conjuntos distintos, para treinamento e para teste, com o objetivo de validar a eficácia de um modelo de aprendizado de máquina. Nesse contexto, qual função do SciKit-learn ele deve utilizar para realizar essa divisão de maneira eficiente e adequada?
Provas
Uma cientista de dados percebeu que, ao processar alguns documentos, seria melhor remover palavras que aparecem em quase todo texto, as stop-words.
Para começar sua lista de stop-words, ela pode escolher listar todos os
Provas
O método de POS-tagging, ou Part of Speech tagging, é uma tarefa do processamento de linguagem natural em que
Provas
Em redes convolucionais, o tamanho do passo normalmente é menor que o tamanho do filtro.
Se o tamanho do passo for maior que o tamanho do filtro, é possível que
Provas
Na arquitetura de redes neurais, diferentes funções de ativação são utilizadas nas camadas de neurônios para aplicar transformações não lineares aos dados. Uma dessas funções é a ReLU, conhecida por sua eficácia em diversos modelos de aprendizado profundo.
Ao implementar a função ReLU, um pesquisador deve seguir a fórmula:
Provas
No gráfico XY, são apresentados pontos que representam duas propriedades de elementos de duas classes, R e S. Os pontos da classe R, representados como círculos, são [(3,5),(3,4),(2,3)], enquanto os pontos da classe S, representados como quadrados, são [(4,3),(4,2),(4,1),(3,1),(2,2)]. É necessário classificar pontos novos, de acordo com o algoritmo K-NN, com K=3, considerando a distância euclidiana.
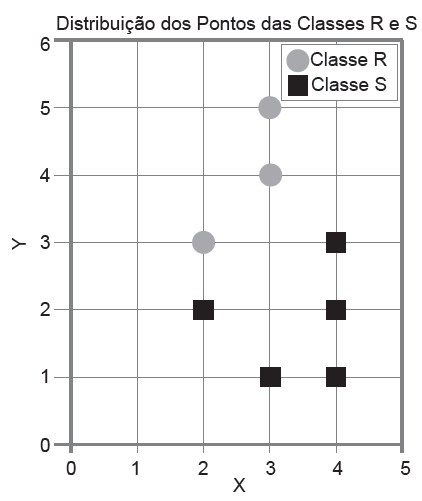
Nesse contexto, as classes dos pontos [(3,2),(3,3) e (4,4)] são, respectivamente:
Provas
Em processamento de linguagem natural, o modelo Skip-Gram é uma técnica popular para treinar word embeddings.
O treinamento do modelo Skip-Gram destaca-se de outras técnicas, como o Continuous Bag of Words (CBOW), por ter a seguinte característica:
Provas
Um pesquisador iniciante em aprendizado de máquina trabalhava com um modelo de classificação binário com as duas classes equilibradas. Inicialmente, ele fez a avaliação de seu modelo, separando 20% dos dados disponíveis para a avaliação, e o treinou com 80% dos dados, fazendo o processo apenas uma vez. Depois, a pedido de seu chefe, ele trocou a forma de avaliação, separando o conjunto de dados em 10 partes e escolhendo, em 10 rodadas, uma parte diferente para avaliação e as outras para treinamento.
Essas duas formas de avaliar um modelo são conhecidas, respectivamente, como
Provas
Caderno Container