Foram encontradas 5.370 questões.
João e Júlio fazem parte da equipe de Ciência de Dados do TCE/ES e estão realizando um estudo para o desenvolvimento de um classificador binário (classes positiva e negativa) usando Naive Bayes. Com o intuito de dividirem suas tarefas, João ficou responsável por treinar o modelo de classificação, e Júlio, por avaliar o desempenho do modelo. Após o treinamento do modelo, João aplicou-o ao conjunto de teste e enviou um e-mail a Júlio com a matriz de confusão resultante.
Dessa forma, Júlio poderá calcular:
Provas

Uma Rede Neural Artificial (RNA) feed-forward sem nenhum bias possui uma camada oculta composta de três neurônios e uma camada de saída composta por dois neurônios. A função de ativação da camada oculta e da camada de saída é a Rectified Linear Unit (ReLU), onde
!$ f(x) = \left \{ \begin{matrix} x, se & x \ge 0 \\ 0, se & x<0 \end{matrix} \right. !$
e as matrizes
!$ W !$1 = !$ \begin{bmatrix} 0,1 & -0,2 \\ 0,4 & 0 \\ 0 & 0,2 \end{bmatrix} !$ e !$ W !$2 =!$ \begin{bmatrix} 0,3 & -0,5 & 0,1 \\ 0 & 0,2 & -0,1 \end{bmatrix} !$
representam os pesos entre a camada de entrada e a camada oculta e entre a camada oculta e a camada de saída, respectivamente.
Considerando um vetor de entrada !$ X !$ = !$ \begin{bmatrix} 1 \\ 2 \end{bmatrix} !$, o vetor de saída será:
Provas
Ao ser contratado por uma empresa da área de e-commerce, o cientista de dados Pedro foi alocado a um importante projeto: desenvolver um classificador para análise de sentimentos considerando as opiniões emitidas no Twitter pelos clientes dessa empresa. Para o início do trabalho, Pedro recebeu um pequeno conjunto de dados de tweets parcialmente anotados, que foram coletados da rede social por intermédio de uma API, usando como palavras-chave na busca os nomes de diversas empresas de e-commerce.
Como parte das escolhas de técnicas a serem utilizadas no projeto, Pedro optou pelo uso de word embeddings, com o objetivo de resolver o problema muito comum em processamento de linguagem natural de:
Provas
Ana está desenvolvendo um banco de dados analítico a partir da integração de dados do sistema de pagamento com o sistema de gestão de pessoal. No sistema de pagamento, os colaboradores são identificados pelo CPF. No sistema de gestão de pessoal, os colaboradores são identificados pelas iniciais do seu nome concatenadas com sua data de nascimento. Ana sabe que essas chaves primárias naturais apresentam diversas desvantagens e riscos para um ambiente de análise de dados integrados, como seu reuso e alteração de regras de composição, além de questões de desempenho.
Com isso, para carregar os dados no banco de dados analítico, Ana desenvolveu um ETL que substituiu as chaves naturais dos sistemas por uma chave artificial contendo inteiros simples sequenciais, utilizando uma:
Provas
Como analista de dados, Joaquim quer comparar os dados de vendas dos produtos de bandeiras e torcidas da sua empresa com os resultados da Copa do Mundo ao longo dos anos. Para isso, Joaquim precisa dos dados dos vencedores das Copas que estão disponíveis em https://pt.wikipedia.org/wiki/Lista_de_finais_da_Copa_do_Mundo_FIFA.
No Power BI, para obter os dados disponíveis na URL https://pt.wikipedia.org/wiki/Lista_de_finais_da_Copa_do_Mundo_FIFA, Joaquim deve selecionar a fonte de dados do tipo:
Provas
A recente explosão de machine learning e deep learning tornou os tensores populares. TensorFlow e PyTorch são dois frameworks com suporte a API de tensor.
Em relação aos tensores, assinale a opção incorreta.
Provas
1. linhas = sc.textFile("dados.txt")
2. linhasComprimento = linhas.map(lambda s: len(s))
3. totalComprimento = linhasComprimento.reduce(lambda a, b: a + b)
Em relação ao código pyspark acima, assinale a afirmativa incorreta.
Provas
O principal objetivo do Hadoop YARN foi dividir as funcionalidades de gerenciamento de recursos e agendamento/monitoramento de tarefas em daemons separados.
Assinale a opção que não figura como uma característica da arquitetura de Hadoop YARN.
Provas
Considere a consulta de streaming que conta os cliques dos usuários por país para uma campanha publicitária na web a cada 30 minutos. Ao aplicar o modelo de processamento de micro batch a esta consulta, o fluxo de dados é dividido em duas fases: batching e processing, como mostra a figura a seguir.
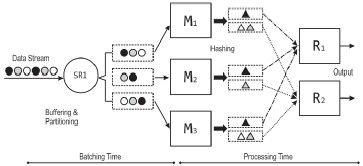
O processamento stream é obtido repetindo as fases de batching e processing para as novas tuplas de dados.
Em relação ao processamento stream em micro-batches, assinale a opção incorreta.
Provas
O Apache Spark é um framework para processamento paralelo e oferece suporte ao processamento na memória para aumentar o desempenho de aplicações de big data.
Em relação aos RDDs e a suas operações, assinale a afirmativa incorreta.
Provas
Caderno Container