Foram encontradas 5.370 questões.
1. Business Intelligence 2. Data Warehouse 3. OLAP
A. Combina análise empresarial, mineração de dados, visualização de dados, ferramentas/infraestrutura de dados e práticas recomendadas para ajudar as organizações a tomar decisões impulsionadas por dados. As soluções modernas priorizam a análise de autoatendimento flexível, dados governados em plataformas confiáveis, a autonomia dos usuários comerciais e o acesso rápido à informação.
B. É um repositório central de informações que podem ser analisadas para propiciar a tomada de decisões mais adequadas. Os dados fluem de sistemas transacionais, bancos de dados relacionais e de outras fontes para tal repositório normalmente com uma cadência regular.
C. É um conceito de interface com o usuário que proporciona a capacidade de ter ideias sobre os dados, permitindo analisálos profundamente em diversos ângulos. Suas funções básicas são fornecer visualização multidimensional dos dados, exploração, rotação e diferentes modos de visualização; é, portanto, uma interface com o usuário e não uma forma de armazenamento de dados, porém usa o armazenamento para poder apresentar as informações.
A relação correta é
Provas

from pandas import DataFrame import matplotlib.pyplot as plt from sklearn.cluster import KMeans Data = {'x': [36,35,23,28,34,32,30,23,36,34,66,55,56,44,51,56,52,51,64,48,4 9,50,36,34,43,46,40,42,52,47],
'y':
[76,52,52,79,60,73,73,58,70,76,52,33,41,45,52,37,36,59,60,51,2 6,21,15,13,21,10,30,28,10,17] }
df = DataFrame(Data,columns=['x','y']) m = KMeans(n_clusters=3).fit(df) d = m.cluster_centers_ plt.xlabel("X") plt.ylabel("Y") plt.scatter(df['x'], df['y'], c= m.labels_.astype(float), s=100, alpha=0.5) plt.scatter(d[:, 0], d[:, 1], c='red', s=250, marker='*') plt.grid() plt.show()
O resultado da execução é
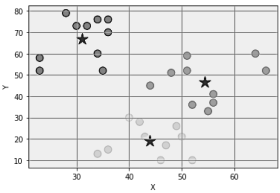
As estrelas indicam
Provas
Provas
Provas
Provas
Considere o trecho de código abaixo escrito na linguagem Python 3.x sobre modelos preditivos de classificação usando a biblioteca scikit learn (sklearn):
from sklearn import tree
X = [[0, 0, 0], [1, 1, 1], [0, 0, 1], [1, 1, 0] ]
y = [0, 1, 0, 1]
clf = tree.DecisionTreeClassifier()

# inserir o código que irá construir/treinar o modelo classificador
Assinale a alternativa CORRETA que corresponde à linha de código que irá construir um classificador (estimador) baseado em árvores de decisão a partir do conjunto de dados de treinamento:
Provas
Considere o modelo dimensional de um data warehouse a seguir:
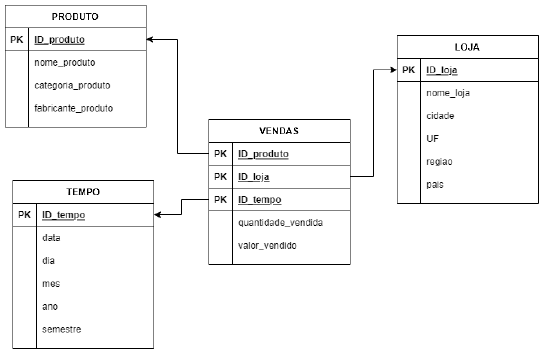
Analise as afirmativas referentes aos conceitos e definições de modelo dimensional e data warehouse
I – As tabelas PRODUTO, TEMPO e LOJA representam dimensões e a tabela VENDAS é uma tabela fato.
II – O modelo dimensional apresentado é um modelo do tipo flocos de neve (snowflake schema).
III – No modelo dimensional do tipo estrela (star schema), geralmente as dimen-sões estão normalizadas e não há redundância de dados.
Está CORRETO o que se afirma em:
Provas
Disciplina: TI - Ciência de Dados e BI
Banca: CESPE / CEBRASPE
Orgão: TRT-8
No módulo NumPy, utilizado no aprendizado de máquina do Python 3,
Provas
Disciplina: TI - Ciência de Dados e BI
Banca: CESPE / CEBRASPE
Orgão: TRT-8
Acerca de modelos preditivos e descritivos, assinale a opção correta.
Provas
Disciplina: TI - Ciência de Dados e BI
Banca: CESPE / CEBRASPE
Orgão: TRT-8
Quanto à avaliação de modelos preditivos, assinale a opção correta.
Provas
Caderno Container